public/projects/ içindeki referans paketleri Apple M5 Pro üzerinde hesaplanmıştır: bazı modeller CPU motorunda 4 iş parçacığıyla, diğerleri Metal GPU motorunda çalıştırılmıştır (GPU motoru). Bu sayfa bir Windows masaüstü sistemini ekleyerek hem sonuçları hem çözücü sürelerini karşılaştırır.
Sistem
| CPU | AMD Ryzen 9 7900X, 12 çekirdek / 24 iş parçacığı |
| RAM | 32 GB DDR5-7200 (2 × 16 GB, çift kanal) |
| GPU | NVIDIA GeForce RTX 3060, 12 GB (yalnızca aşağıdaki CUDA çalıştırmalarında kullanılmıştır) |
| İşletim sistemi | Windows 11 Pro 25H2, derleme 26200 |
| openEMS | v0.37.0-rc3, resmi MSVC derlemesi (CPU motoru “compressed SSE + multi-threading”) |
| Python | 3.13.15, depo sanal ortamı (docs/WINDOWS.md) |
Olağan masaüstü programları (tarayıcı, sohbet istemcileri) açıktı; boşta yük %5–11 arasındaydı.
Komutlar
Kayıtlı paketler oluşturulurken olduğu gibi her model varsayılan parametreleriyle; Sierpinski monopolü iki kez (--set iterations=0 / 3) çalıştırılmıştır. Her çalıştırma bir kez 4 iş parçacığıyla, bir kez tüm çekirdeklerle yapılmıştır. public/projects/ içine hiçbir şey yazılmaz:
$B = ".sim\bench"   # in the repository root (ignored by git)
python -m fairbeam run python\models\patch_antenna.py --threads 4 --quiet --out "$B\t4"  --sim-root "$B\sim"
python -m fairbeam run python\models\patch_antenna.py --threads 0 --quiet --out "$B\all" --sim-root "$B\sim"
# ... every model in python\models; the Sierpinski monopole with --set iterations=0 and --set iterations=3

python scripts\bench_compare.py --run "t4=$B\t4" --run "all=$B\all" --json docs\benchmarks\windows-7900x.json --markdown
Ham değerler benchmarks/windows-7900x.json (yeni sekmede açılır) dosyasındadır.
Sonuçlar
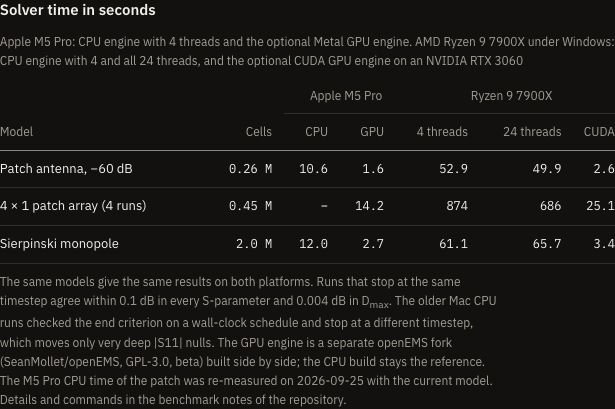
Çözücü süreleri tüm port çalıştırmalarının toplamıdır. M5 Pro sütunları kayıtlı paketlere aittir: cpu/4, 4 iş parçacıklı CPU motorunu; gpu, Metal motorunu belirtir. Δ, Windows (4 iş parçacığı) eksi M5 Pro değeridir.
| Model | Hücre | Zaman adımları M5 Pro → Windows | Windows 4 iş parçacığı | Windows 24 iş parçacığı | M5 Pro | M5 Pro motoru | Δ|S11| min | ΔDmax | Δ verimlilik | max Δ|Sij| (−30 dB üzeri) |
|---|---|---|---|---|---|---|---|---|---|---|
| Dipol | 194,940 | 10842 → 8505 | 49,2 s | 46,7 s | 16,1 s | cpu/4 | +4,40 dB | +0,004 dB | +0,001 | – |
| İçten beslemeli yama | 173,932 | 9440 → 6966 | 45,7 s | 54,3 s | 12,1 s | cpu/4 | −0,34 dB | +0,001 dB | −0,007 | – |
| Minkowski yaması | 123,008 | 29073 → 26334 | 111,9 s | 99,0 s | 16,1 s | cpu/4 | +0,51 dB | 0,000 dB | −0,003 | – |
| Yama anten | 276,138 | 18468 → 12628 | 46,6 s | 49,9 s | 16,1 s | cpu/4 | −1,48 dB | −0,001 dB | −0,016 | – |
| Sierpinski, yineleme 0 | 1,879,416 | 3380 → 3960 | 48,4 s | 61,3 s | 8,0 s | cpu/4 | −0,01 dB | −0,007 dB | −0,001 | – |
| Sierpinski, yineleme 3 | 2,012,304 | 4930 → 5250 | 61,1 s | 65,7 s | 12,0 s | cpu/4 | 0,00 dB | ≤ 0,007 dB | ≤ 0,001 | – |
| Eksenel mod helis | 1,391,208 | 17200 → 17270 | 489,4 s | 336,4 s | 10,3 s | gpu | −1,09 dB | 0,000 dB | 0,000 | – |
| Piramit huni | 1,136,520 | 10800 → 10320 | 224,6 s | 153,3 s | 5,6 s | gpu | −0,26 dB | ≤ 0,005 dB | ≤ 0,002 | – |
| Mikroşerit hat | 53,792 | 7040 (aynı) | 10,7 s | 4,9 s | 0,85 s | gpu | 0,00 dB | – | – | 0,003 dB |
| Yama dizisi 2 × 1 | 52,947 | 15225 (aynı) | 106,0 s | 84,9 s | 2,1 s | gpu | 0,00 dB | 0,000 dB | 0,000 | 0,002 dB |
| Yama dizisi 4 × 1 | 452,270 | aynı, 4 çalıştırma | 873,8 s | 686,4 s | 14,2 s | gpu | −0,09 dB | ≤ 0,004 dB | 0,000 | 0,093 dB |
| Wilkinson bölücü | 113,103 | aynı, 3 çalıştırma | 41,1 s | 25,7 s | 2,1 s | gpu | 0,00 dB | – | – | 0,001 dB |
| Dal hatlı kuplör | 81,432 | 8883 (aynı), 4 çalıştırma | 49,0 s | 20,8 s | 2,4 s | gpu | 0,00 dB | – | – | aşağıya bakın |
| Kademeli alçak geçiren filtre | 133,977 | 23744 (aynı), 2 çalıştırma | 55,2 s | 42,6 s | 4,1 s | gpu | 0,00 dB | – | – | aşağıya bakın |
Yama anten, 4 iş parçacığı, üç çalıştırma: 46,6; 52,9 ve 58,0 s, medyan 52,9 s (masaüstü kullanımdayken ±%11).
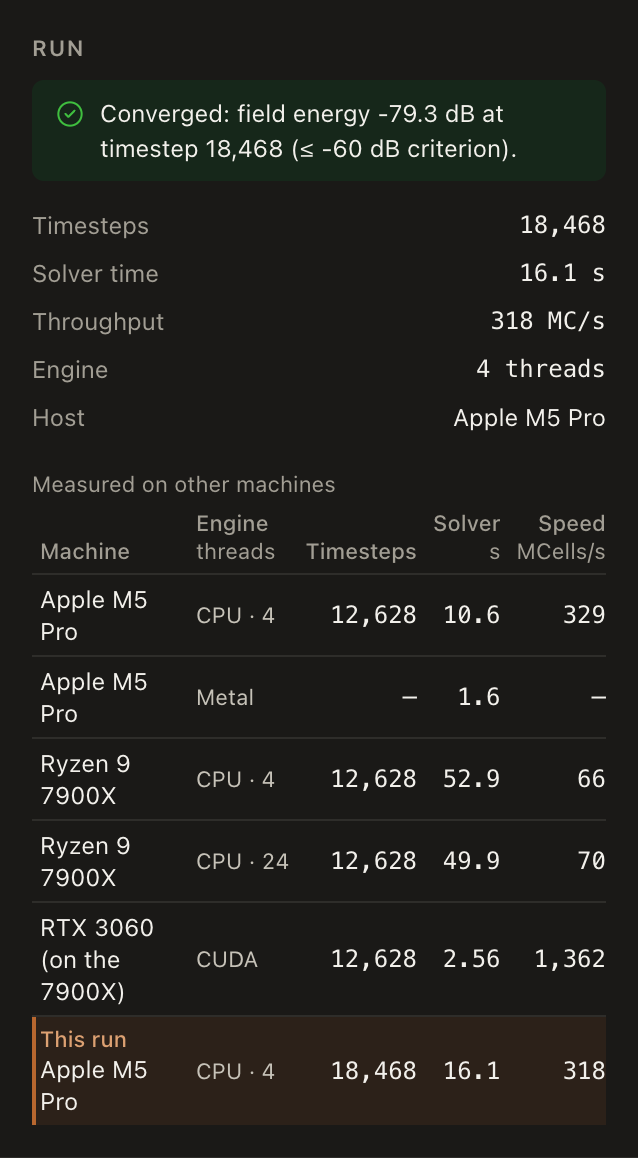
Aynı yama anten, M5 Pro üzerinde 2026-09-25 tarihinde yeniden ölçülmüştür: güncel model ve aynı komutla (CPU motoru, 4 iş parçacığı, geçici klasöre) 12628 zaman adımı, Windows ile aynı durma noktası ve 10,6 s çözücü süresi elde edilmiştir (iki çalıştırmanın en iyisi: 10,59 ve 10,75 s; duvar saati süresi 11,5 s; 329 MCells/s). Aynı zaman adımı sayısında 7900X, 4 iş parçacığıyla 5,0 kat uzun sürer (52,9 s). Yukarıdaki kayıtlı paketin 16,1 s değeri, 18468 zaman adımında duran eski çalıştırmaya aittir.
Tablolardaki “Hücre” değeri, paketlerde saklandığı biçimiyle eksen başına mesh çizgisi sayılarının çarpımıdır (run.grid); web sitesi çizgiler arasındaki hücreleri sayar (yama anten: 68 × 68 × 57 = 0,26 M).
Karşılaştırmanın gösterdikleri
- Denenen aynı zaman adımlı çalışmalarda uyum. İki platformun aynı zaman adımında durduğu durumlarda (mikroşerit hat, iki yama dizisi, Wilkinson bölücü), Windows CPU motoru ile M5 Pro Metal GPU motoru; −30 dB üzerindeki tüm S-parametrelerinde 0,1 dB, Dmax'ta 0,004 dB içinde uyuşur.
- Eski M5 Pro CPU paketlerinde durma zaman adımı farklıdır. Bu paketler, Fairbeam durdurma ölçütünü sabit zaman adımı takviminde (
exact_endcriteria) kontrol etmeye başlamadan önce oluşturulmuştur. openEMS o dönemde yaklaşık her 4 s duvar saati süresinde kontrol yaptığı için çalıştırma bir sonraki denetimin denk geldiği yerde duruyordu. Örneğin dipol 10842 zaman adımı çalışmıştı (denetimler 2808, 5538, 8268, 10842); Windows ise −60 dB altındaki ilk Nyquist periyodu denetimi olan 8505'te durur. Dmax yine 0,007 dB, verimlilik 0,016 içinde uyuşur; yalnızca çok derin |S11| çukurları 4,4 dB'ye kadar kayar. - Dal hatlı kuplör ve kademeli alçak geçiren filtre: Windows çalıştırmasının karşılaştırıldığı paketler, model kodunun mesh'inden eskiydi (mesh üreticisindeki bölünmüş aralık kademelendirme düzeltmesi, Otomatik mesh oluşturma); dolayısıyla ızgaralar farklıydı. İkisi de 2026-09-25 tarihinde M5 Pro Metal motorunda yeniden çalıştırılıp kaydedilmiştir; yukarıdaki satırlar yeni paketleri
windows-7900x.jsoniçindeki değerlerle karşılaştırır (Windows paketleri saklanmamıştır). Izgara, durma zaman adımı ve |S11| minimumu artık tam eşleşir (iki platformda da dal hatlı kuplör: 2,4137 GHz'de −34,845 dB; alçak geçiren filtre: 2,027 GHz'de −48,0 dB). JSON tam S-matrisi içermediğinden bu ikisi için en yüksek Δ|Sij| verilemez. - Hız. Hücre ve zaman adımı başına M5 Pro CPU motoru, 4 iş parçacığıyla bu Windows derlemesinin 4 iş parçacıklı çalıştırmasından 4–8 kat hızlıdır (yama anten: 75'e karşı 318 MCells/s).
- İş parçacıkları. Daha fazla iş parçacığı Windows derlemesine yalnızca bazı modellerde yarar sağlar: 4'ten 24'e geçince çok portlu modeller, helis ve huni %20–58 daha kısa sürerken tek portlu antenlerde süre aynı kalır veya artar (Sierpinski, yineleme 0: 48 → 61 s). Bu sistem için dört iş parçacığı uygun bir varsayılandır.
İş parçacıkları: “Otomatik” ne yapar?
Ayarlar, Çalıştır iletişim kutusu ve Simülasyon çalıştır paneli Otomatik seçeneğini sunar (yeni kurulumlarda varsayılandır). Sunucu (python/fairbeam/resources.py, auto_threads) sayıyı sisteme ve ızgaraya göre seçer:
- Sanal iş parçacıklarını değil fiziksel çekirdekleri sayar (FDTD çekirdeği bellekle sınırlıdır: 7900X üzerinde 24 iş parçacığı, 4 iş parçacığının 0,6–2,4 katı hız sağlamış ve tek portlu antenlerde daha yavaş kalmıştır).
- 4 veya daha fazla fiziksel çekirdekte birini uygulamaya bırakır; 1 veya 2 çekirdekte 1, 3 çekirdekte 3 kullanır.
- Sayıyı ızgara boyutuna göre sınırlar: 0,5 M hücrenin altında (veya boyut bilinmiyorsa) 4; 2 M altında 8; üzerinde 12 iş parçacığı (en büyük örnek ızgaraları yaklaşık 2 M hücredir).
- Sürecin kullanmasına izin verilen CPU'lar dikkate alınır (CPU yakınlığına uyulur; yedek değer mantıksal CPU sayısıdır); elle seçilen sayı da bu sınırla kısıtlanır.
Sonuç: en az 4 fiziksel çekirdeği olan 8 veya daha fazla mantıksal CPU'lu sistemlerde küçük ızgaralar için 3–4 iş parçacığı, 12 çekirdek/24 iş parçacıklı bir bilgisayarda 4 (2 M hücrenin üzerinde en fazla 11) seçilir. Elle girilen sayı her zaman Otomatik seçimine üstün gelir; “Otomatik” bir kaynak tercihidir, sıcaklık garantisi değildir.
Geçiş: Ayarlar'da saklanan değer tam 4 ise (eski varsayılan; bilinçli seçilen 4'ten ayırt edilemez) bir kez Otomatik'e çevrilir; diğer tüm sayılar korunur. Tek CLI çalıştırması da artık aynı sistem/mesh tabanlı Otomatik politikasını varsayılan olarak kullanır. Açıkça verilen --threads 0, openEMS'in bir iş parçacığıyla başlayıp ilerleme aralıklarında ayarlama yapan yerel ayarlayıcısını kullanır; tüm çekirdekler anlamına gelmez. Tarama, yakınsama ve optimizasyonun varsayılanı 4 olarak kalır.
Çalıştırma öncesi süre tahmini ve ön denetim
Süre tahmini şu sırayla veri kullanır: önce bu bilgisayarın önceki çalıştırmalarının medyan MCells/s değeri (index.json içinde speed_mcells_s ve host_cpu, aynı motor); yoksa ölçüm tablosunda aynı CPU adına sahip bilgisayarın satırlarının medyanı; o da yoksa küçük ızgaralar için düşürülmüş sabit 250 (CPU) / 700 (GPU) MCells/s. İletişim kutusu hangi kaynağı kullandığını belirtir.
Çalıştırma öncesinde sunucu (POST /api/preflight; mesh boyutu cells olarak geldiğinde POST /api/runs da uygular), hücre başına yaklaşık 90 bayt tahmin edip boş bellekle karşılaştırır: %60'ın üzerinde uyarır, %90'ın üzerinde açıklamayla reddeder. Başka bir çalıştırma CPU'yu kullanıyorsa veya sistem yükü yüksekse de uyarır. CUDA GPU belleği okunmaz (bilinmiyor olarak gösterilir, güvenli denmez); Metal'de birleşik bellek bir kez kontrol edilir. Hiçbir ayar otomatik olarak kabalaştırılmaz veya gevşetilmez.
Aynı sistemde CUDA GPU motoru
GPU: NVIDIA GeForce RTX 3060, 12 GB, hesaplama yeteneği 8.6, sürücü 591.74. Motor: openEMS türevinin scripts\install-openems-gpu-windows.ps1 ile kurulan Windows CUDA paketi v0.37.0-beta1+gpu (GPU motoru).
$env:OPENEMS_INSTALL_PATH = "C:\opt\openEMS-gpu"
C:\opt\openEMS-gpu\venv\Scripts\python.exe -m fairbeam run python\models\patch_antenna.py --engine gpu --out "$B\gpu" --sim-root "$B\sim"
python scripts\bench_compare.py --run "cuda=$B\gpu" --ref "$B\t4" --json docs\benchmarks\windows-7900x-rtx3060-cuda.json| Model | Hücre | Zaman adımları CPU → CUDA | CPU, 4 iş parçacığı | CUDA | CUDA MHücre/s | ΔDmax (CPU ile) | max Δ|Sij| (CPU ile) |
|---|---|---|---|---|---|---|---|
| Yama anten | 276,138 | 12628 (aynı) | 52,9 s (medyan) | 2,56 s (medyan) | 1376 | 0,000 dB | – |
| 4 × 1 yama dizisi | 452,270 | aynı, 4 çalıştırma | 873,8 s | 25,1 s | 1424 | 0,000 dB | 0,000 dB |
| Piramit huni | 1,136,520 | 10320 → 10800 | 224,6 s | 6,3 s | 1948 | ≤ 0,004 dB | – |
| Sierpinski, yineleme 3 | 2,012,304 | 5250 → 5200 | 61,1 s | 3,4 s | 3052 | ≤ 0,009 dB | – |
| Wilkinson bölücü | 113,103 | aynı, 3 çalıştırma | 41,1 s | 4,4 s | 825 | – | 0,000 dB |
CUDA üzerinde yama anten, üç çalıştırma: 2,53; 2,56 ve 2,58 s (medyan 2,56 s, ±%1). Her çalıştırmanın günlüğü arka ucu CUDA (NVIDIA GeForce RTX 3060) olarak adlandırır ve her paket run.engine: gpu kaydeder. Apple M5 Pro Metal paketleriyle (huni, 4 × 1 dizi ve Wilkinson; hepsi aynı zaman adımında) karşılaştırıldığında CUDA sonuçları, −30 dB üzerindeki tüm S-parametrelerinde 0,1 dB, Dmax'ta 0,005 dB içinde uyuşur. Ham değerler benchmarks/windows-7900x-rtx3060-cuda.json (yeni sekmede açılır) dosyasındadır.
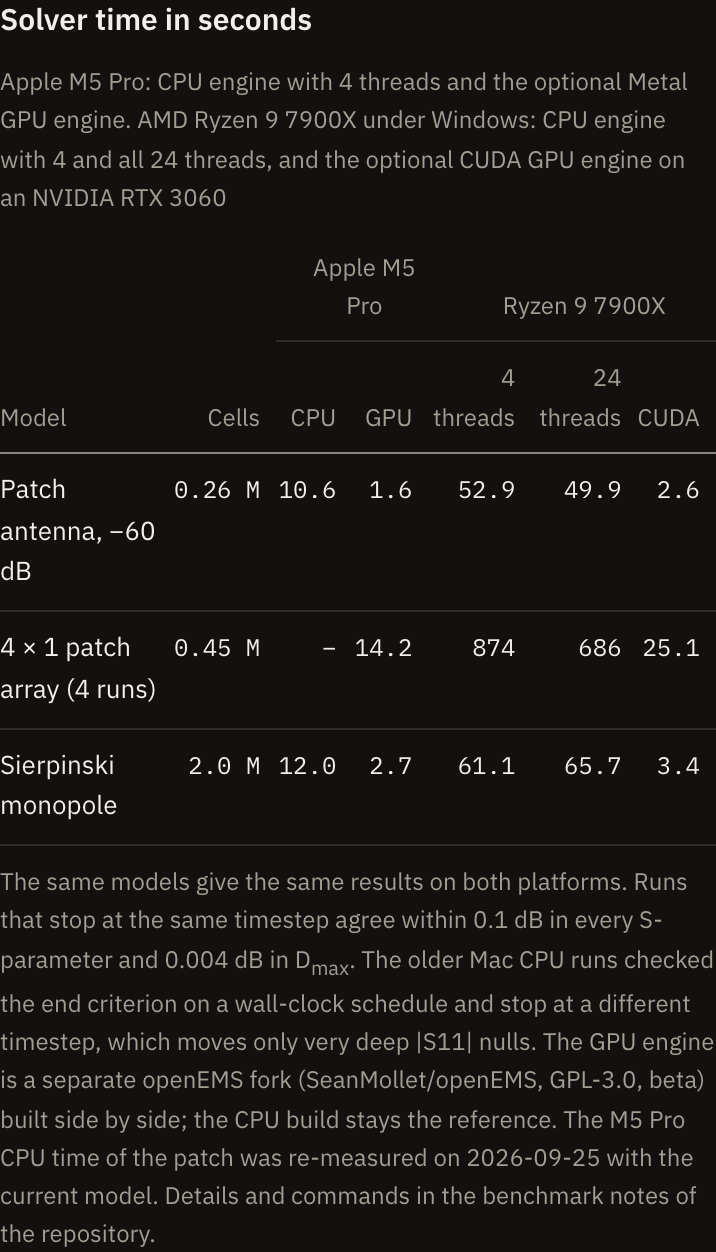
Web sitesinin bu değerlerden oluşturulan “Çözücü süresi” tablosu (landing/features.html, #results), masaüstü ve telefon genişliğinde:
Görüntüleyicide
Sonuçlar panelinin Çalıştırma bölümünde, açık model için bu ölçümler “Diğer makinelerde ölçülen” tablosunda gösterilir (sistem, motor ve iş parçacıkları, zaman adımları, port çalıştırmalarının toplam çözücü süresi, MCells/s). Yalnızca ölçülmüş satırları listeler; açık paketin kendi çalıştırmasını işaretler veya “Bu çalıştırma” olarak ekler. Açık paketin parametreleri veya ızgarası ölçülenlerden farklıysa bunu belirtir. Veri kaynağı public/benchmarks.json dosyasıdır; benchmarks/*.json, public/projects/ içindeki kayıtlı paketler ve yalnızca bu sayfada veya GPU motoru belgesinde belirtilen değerlerden üretilir (scripts/benchmarks-from-docs.mjs). Yeni bir ölçümden sonra:
npm run build:benchmarks        # rewrite public/benchmarks.json
npm run check:benchmarks        # fails when the committed file is out of date
Kayıtlı yama anten paketinin tablosu; eski çalıştırması (18468 zaman adımı), yeniden ölçülen 10,6 s değerinin altında “Bu çalıştırma” olarak eklenmiştir: